Blog de Desarrollo
Conocimientos expertos sobre sistemas de agentes IA, aplicaciones LLM, prompt engineering e ingenieria de software moderna. Aprende de experiencia real construyendo aplicaciones potenciadas por IA de produccion.
Agentes IA en Produccion: Como Construir Sistemas Multi-Agente Que Realmente Funcionen
Solo el 11% de las empresas tienen agentes IA en produccion. Aprende como cerrar la brecha entre demo y despliegue con guia practica sobre sistemas multi-agente, protocolos MCP, A2A y arquitecturas del mundo real.
API Decisions de OpenAI: Respuestas Tipadas, No Texto
La Decisions API de OpenAI (beta pública, 6-oct-2026) devuelve respuestas tipadas sí/no, choice y score a $0.10/1M de input. Formas de los docs, evals, fallbacks y Clef.
Moli: El Navegador Headless en Rust Hecho para Agentes IA
Moli es un navegador headless en Rust para agentes IA: Markdown de salida y CDP. Cómo funciona, cómo se compara con browser-use y Stagehand, y sus límites.
Python 3.15 para Devs de Apps con LLM: Lazy Imports, UTF-8 por Defecto y un Profiler de Muestreo
Python 3.15 ya salió: lazy imports, UTF-8 por defecto, sentinel, frozendict y un profiler de muestreo. Qué cambia para apps LLM y agentes, con plan de una semana.
Validación de Backtests en 2026: Walk-Forward, Purga y Deflated Sharpe Ratio
Fugas de información, walk-forward con purga, costos de trading y Deflated Sharpe Ratio: un tutorial práctico en Python sobre datos sintéticos que no promete ganancias.
ds4 (DwarfStar): el Motor Nativo de antirez para DeepSeek V4 Flash
El motor en C de antirez para DeepSeek V4 Flash en Metal, CUDA y ROCm: qué modelos corre, cuánta memoria pide, un quickstart y cuándo conviene llama.cpp o MLX.
Cómo Medir tu Visibilidad en Búsqueda con IA en 2026: Crawlers, GA4 y Logs
GA4 muestra 91% Direct y la IA parece ruido. Un playbook 2026: bots verificados, robots.txt por bot, canal de IA en GA4, scripts de logs y números reales.
Mistral Large 4: la preview open-weight que todavía no podés descargar
Mistral Large 4: MoE de ~1T parámetros en preview pública desde el 6-oct-2026. Ficha, precios, quickstart en Python y por qué los pesos aún son promesa.
Armá un Agente de Voz en 2026: Pipeline con LiveKit, Tool Calls y Presupuesto de Latencia
Agente de voz STT→LLM→TTS práctico con LiveKit Agents 1.8: VAD, turnos, barge-in, tool calls, traspaso SIP y presupuesto de latencia, con Pipecat comparado.
iFixAi: La Auditoría de 60 Inspecciones para Agentes de IA y Cuánto Cuesta Realmente Correrla
iFixAi audita si un agente de IA hace su trabajo con 60 inspecciones y nota A–F. Cuánto cuesta una corrida por defecto, qué envía y qué no puede probar.
Armá un Agente de Auditoría de Repos con el Claude Agent SDK (y Conocé sus Límites)
Armá un agente de auditoría de repos de solo lectura con el Claude Agent SDK en Python: tool propia, hook PreToolUse, callback de permisos, subagente y los límites.
Agentes Durables en 2026: Que Tu Agente de IA Sobreviva a Timeouts, Deploys y Humanos Lentos
Por qué los agentes largos se rompen con límites serverless y deploys, cómo comparan Vercel Workflow, Temporal e Inngest y un agente TypeScript con aprobación.
EmbeddingGemma 2: Embeddings Multimodales Abiertos que Corren en Local
El modelo de embeddings abierto de ~740M de Google mapea texto, código, imágenes, video y audio a un espacio de 768 dims. Quickstart, licencia, almacenamiento y límites.
WeKnora: la Plataforma de Conocimiento RAG y Agentes Open Source de Tencent
La plataforma open source de RAG, agente y wiki de Tencent (~34K estrellas): arquitectura en 4 pasos, quickstart del README, licencia y defaults de seguridad.
Claves de API de OpenAI en 2026: Expiración, Tipos de Clave e Identidad de Workload
OpenAI ya expira claves de API de proyecto, limita su vida y restringe tipos de clave; la identidad de workload cambia secretos guardados por tokens de corta vida.
Agente Text-to-SQL en Postgres en 2026: Que el Modelo Escriba el SQL y la Base Diga que No
Armá un agente text-to-SQL en Postgres donde la base es el límite: rol de solo lectura, schema grounding, gate de costo con EXPLAIN y harness de accuracy.
DeepSeek V4.1 Flash: Qué Cambió y Cómo Migrar
DeepSeek V4.1 Flash ya salió: pesos MIT, 1M de contexto, entrada de imágenes y un nuevo nombre de API. Qué cambió, cómo migrar y los límites que conviene conocer.
PageIndex: RAG sin Vectores donde un LLM Navega el Árbol del Documento
PageIndex reemplaza la búsqueda vectorial por un LLM que recorre un árbol del documento. Qué hace el modo local MIT, qué es solo de la nube, costos y cuándo evitarlo.
La Prompt Injection No Está Resuelta: Diseñá Tus Agentes Alrededor de Ella
La prompt injection no se parchea dentro del LLM. Auditá un agente de email contra la lethal trifecta y sumá allow-list de egreso, LLM en cuarentena y gates humanos.
OpenAI DevDay 2026: Qué Salió de Verdad para Devs
DevDay 2026 de OpenAI leído desde su changelog y docs: Agents API en beta con computer use, Ultrafast a 6x de precio, GPT-6.1 Sol, Codex cloud y lo que es solo anuncio.
GPT-6.1 Sol y el Tier Ultrafast: Guía para Constructores de Agentes
GPT-6.1 Sol mantiene el precio de $2/$10 con caché más barata, y Ultrafast vende velocidad a 6x. Qué cambió vs GPT-6 Sol, código y cuándo no conviene pagar.
Ejecutá Código Escrito por Agentes Dentro de un Sandbox: Timeouts, Límites y Sin Egress
Armá una tool de code interpreter en un sandbox: timeouts, límites, egress bloqueado y una comparativa E2B vs Vercel vs Modal vs Daytona solo con hechos.
Hindsight: la Memoria de Agentes que Retiene, Recuerda y Reflexiona
Hindsight suma retain, recall y reflect a la memoria de agentes: arquitectura en 4 pasos, quickstart, cómo se compara con Mem0 y OpenViking y cuándo evitarlo.
Deprecaciones de OpenAI: Qué Se Apaga el 23 de Octubre
OpenAI retira GPT-4, o1, o3-mini, o4-mini y gpt-image-1 el 23 de octubre de 2026. Cada fecha de cierre y reemplazo de la tabla oficial, más un checklist de migración de una semana.
LiteLLM como Gateway de LLMs: Presupuestos, Fallbacks y un Setup Seguro
Montá LiteLLM como gateway de LLMs: virtual keys, presupuestos, fallbacks y spend logs según los docs, y cómo correrlo seguro tras el ataque de marzo de 2026.
Gemini 4 Argon: Fairwind, acceso a la API y cuánto cuesta
Gemini 4 Argon ya está en la API de pago como gemini-4-argon. Fairwind explicado, precio intro $2/$10, long decode de 1M tokens y quickstart de la doc.
OpenShell: el Sandbox con Políticas de NVIDIA para Agentes IA, Explicado
OpenShell, el runtime open source de NVIDIA, corre agentes IA en sandboxes con Landlock, seccomp y egreso denegado por defecto. Quickstart, arquitectura y límites.
El Compromiso de MemOS y MemoryOS: Qué Revisar y Qué Rotar
El plugin npm de MemOS y MemoryOS 2.0.34 en PyPI distribuyeron un ladrón de credenciales el 23-09-2026. Qué está confirmado, cómo revisar y qué rotar.
Observabilidad de LLMs en 2026: Trazas, Costo por Token y Redacción de PII con OpenTelemetry y Langfuse
Trazá apps LLM con las convenciones GenAI de OpenTelemetry y Langfuse 5.0.1: uso de tokens, spans de retrieval y tools, costo por usuario, redacción de PII y sampling.
Claude Sonnet 5.5: El Caballo de Batalla, Esfuerzo y Costo
Sonnet 5.5 mantiene los $2/$10 por 1M de tokens de Sonnet 5 y suma between_tools y niveles de esfuerzo recalibrados. Tabla vs Opus 5.5 y Haiku 5.5, migración y costos.
Docker Agent: Definí Agentes de IA en YAML y Corrélos como Plugin de Docker CLI
Docker Agent corre agentes de IA definidos en YAML como plugin de Docker CLI. Arquitectura, quickstart verificado, seguridad, telemetría y cuándo evitarlo.
Claude Haiku 5.5: El Subagente Barato con Niveles de Esfuerzo
Claude Haiku 5.5 a $0.10/$0.50 por 1M de tokens, el primer Haiku con niveles de esfuerzo: patrón worker, aritmética de costos, código y límites honestos.
Evaluación de RAG en CI: Que Falle el Build Antes de Que Tus Usuarios Encuentren la Regresión
Armá un gate de evaluación RAG en CI con Ragas 0.4.3: golden set revisado, fallas de retrieval vs generación, umbrales con ruido y un job de GitHub Actions.
GitSpawn: Cómo un Archivo de Config de Git Ejecuta Código en Tu Agente de IA
El .git/config de un repo puede hacer que agentes de código con IA ejecuten código en un git status en segundo plano. Qué está parcheado y un checklist de hardening.
SkillSpector: Escaneá las Skills de Agentes IA Antes de Instalarlas
SkillSpector de NVIDIA escanea de forma estática las skills de agentes IA: prompt injection, exfiltración y supply chain. Cómo funciona, un gate de CI y sus límites.
Búsqueda Híbrida y Reranking Dentro de Postgres: Medí el Recall, No Adivines
Armá búsqueda híbrida dentro de Postgres: tsvector o BM25 más pgvector, fusión RRF (k=60), reranking con cross-encoder y un harness que mide recall@k.
Mellum2.1: el modelo abierto de JetBrains para agentes de código, local con vLLM
MoE abierto de 12B de JetBrains (2.5B activos, Apache 2.0) para agentes de código: specs, comandos vLLM de la card, loop de agente y límites de un 47.0 autoinformado.
Política de Uso de Anthropic 2026: Qué Cambia el 12 de Nov
La Política de Uso 2026 de Anthropic llega el 12 de nov: sección de actividad engañosa, parada y estado seguro para agentes con hardware y regiones. Tu checklist.
Open Code Review: el CLI de Alibaba con Pipeline de Reglas + LLM
El CLI open source de Alibaba deja que un pipeline de reglas elija qué revisar y que un LLM lo juzgue. Arquitectura, CI, privacidad y cuándo evitarlo.
Servidor MCP Remoto en 2026: Stateless, Autenticado y Desplegable
Crea un servidor MCP remoto autenticado con la spec 2026-07-28: Streamable HTTP stateless, auth OAuth, despliegue tipo Vercel y checklist de migración desde v1.
Grok Voice 3.0: Crea un Agente Speech-to-Speech (y Cuándo No Hacerlo)
Grok Voice 3.0 cuesta $0.08/min. ¿Speech-to-speech o STT→LLM→TTS con MAI-Voice-2.1 de Microsoft? Tabla de costos, cliente mínimo y límites honestos.
GPT-6 Sol vs Luna: Qué Tier para Qué Tarea
OpenAI lanzó GPT-6 Sol ($2/$10) y Luna ($0.10/$0.50): mitad de precio que 5.6, factualidad nivel Astra. Comparación, disponibilidad y router.
Grok 4.7 Ya Está Acá: Qué Cambió xAI Tras 4.6
xAI lanzó Grok 4.7 el 21-sep-2026: base más grande que 4.6, RL más largo en tareas de horas, mismo precio $2/$6. Qué cambió y cómo probarlo.
Claude Opus 5.5: Rendimiento Fable 5.1 a Precio Opus
Anthropic lanzó Opus 5.5 el 22-sep-2026: código nivel Fable, 40% más barato a $4/$20, 30% más rápido, mejores safety scores. Benchmarks y migración.
vMLX en 2026: Tu Mac Como Servidor de Inferencia
vMLX sirve cualquier modelo MLX detrás de una API compatible con OpenAI: batching, caché de 5 capas, cuantización JANG y clusters multi-Mac.
Jev-Flywheel: capa de feedback sobre Jev o Laya, y luego fine-tune
Anthus comparó Jev vs Laya con 140 etiquetas: Jev con flywheel 0.870, Laya 0.802, Laya con fine-tune 0.896.
Rapid-MLX: El Servidor de Inferencia Local que tu Mac Merece
Rapid-MLX es el servidor Apache 2.0 de ~3.8k estrellas para Apple Silicon: API OpenAI-compatible en localhost:8000/v1 y quickstart en 5 minutos.
MLX + mlx-lm: LLMs en tu Mac, de verdad
Memoria unificada, cuantización 4-bit en segundos, LoRA sobre cuantizados y benchmarks M5 vs M4 — el loop completo de LLMs locales en Apple Silicon.
Open-Jev en Qwen: modelos que deciden sin generar
Adapters LoRA convierten Qwen 2B/9B en modelos de decisión tipada con 97,54% de accuracy — más variante 0.4B para CPU y un 27B pendiente.
OpenJev Libera Pesos Abiertos: Decisiones Tipadas al 84% en 210ms
OpenJev libera pesos abiertos para decisiones tipadas en una pasada, hasta 52 opciones: 84.0% de accuracy, builds FP8 y MLX incluidos.
laya-mlx: Laya nativo en Apple Silicon
Port no oficial v0.1.0 (19 sep 2026): decisiones tipadas de Laya en Apple MLX — 7.39 ms P50, menos de 1 GB de RAM, cero tokens.
Modelos de Decisión Tipados para Agentes: Jev vs Laya
Un juez rápido y calibrado supera a una llamada LLM en routing, triage y guardrails. Jev vs Laya con código SDK verificado y el flywheel.
Laya: La Respuesta Open-Source al Jev de TypeSafe
Laya es la respuesta open-source a Jev: 421M de parámetros, decisiones en 33 ms, Apache 2.0. Benchmarks, quickstart con Router y límites honestos.
TypeSafe lanza Jev: decisiones, no strings
TypeSafe AI lanzó Jev el 15-sep-2026: modelo System One no-autorregresivo con probabilidades tipadas a $0.042/1M tokens.
ai-memory: Memoria de Largo Plazo para tus CLIs de Código
Cerrá Claude Code a mitad de tarea y retomá en Codex con todo el contexto. Servidor de memoria en Rust, 6.600+ estrellas, quickstart verificado y límites honestos.
Seguridad MCP 2026: Audita Agentes Antes de Prod
Tus servidores MCP y skills son la nueva superficie de ataque. Audítalos con AI-Infra-Guard de Tencent: scan MCP, revisión de Skills, jailbreak evals y gate en CI.
Qwen3.8 Flash: probé el modelo veloz de Alibaba
Probé el MoE veloz de Alibaba: 6B de parámetros activos, 1/9 del costo de entreno, benchmarks de agentes vs Qwen3 y quickstart con Ollama/vLLM.
Unsloth: Corre y Entrena LLMs en tu Propia GPU
Corre Qwen, Kimi K3, DeepSeek y Gemma en tu GPU: instalación, guía de VRAM, quickstart y límites honestos del repo de 76k estrellas.
Agent Skills 2026: Workflows de IA Reutilizables
Dejá de pegar los mismos prompts en cada sesión. Aprendé el estándar SKILL.md, instalá packs comunitarios y shipeá tu primer workflow reutilizable.
Pagos con Stablecoins 2026: Qué Debe Implementar Fintech
Los payouts con stablecoins licenciados salieron a producción en sep 2026 — Confirmo en la UE, WasabiCard en 200+ países. Qué cambia tu fintech esta semana.
Gemini 3.8 Flash: especificaciones, precio y quickstart
Mismo precio que 3.7 Flash, contexto de 1M, mejor código agéntico — pero +30% tokens por tarea. Specs, benchmarks honestos y quickstart JS/Python funcional.
OpenViking: Memoria + RAG para Agentes de IA
La base de datos de contexto de Volcengine (~33K estrellas) unifica memoria, RAG y skills en un filesystem viking:// — arquitectura, quickstart verificado y límites honestos.
vLLM vs SGLang en 2026: Serví LLMs Más Rápido
Benchmarks en H100, RadixAttention vs prefix caching y comandos verificados — cuándo elegir vLLM o SGLang para tu workload.
JetBrains 2026: 90% de Desarrolladores Ya Usa Agentes de IA
JetBrains encuestó a más de 15.000 devs: 90% usa agentes de IA cada semana, 68% a diario. Claude Code (39%) destronó a Copilot (21%). Qué significa y qué hacer.
Muse Spark 1.3 y Glimmer: el doble lanzamiento de Meta
El doble lanzamiento de Meta: Spark 1.3 cerrado vs Glimmer 30B abierto — ficha, quickstart local y veredicto.
Kimi K3 en 2026: guía del modelo abierto frontier
La frontera open-weight de Moonshot AI: 2.8T, contexto 1M, API $3/$15 y quickstart verificado.
Firecrawl: el scraper open-source que todo dev de LLMs debe conocer en 2026
Firecrawl convierte cualquier web en markdown listo para LLMs con una sola llamada: 176k estrellas, arquitectura en 4 pasos, quickstart verificado y límites honestos.
Khoj: Tu Asistente Personal de IA Autoalojado
Khoj roza las 37k estrellas como segundo cerebro de IA autoalojado. Explico su arquitectura en 4 pasos, verifico el quickstart con Docker y cuándo no usarlo.
Open WebUI: Tu ChatGPT Autoalojado en 5 Minutos
Open WebUI es la interfaz de chat IA autoalojada con más estrellas en GitHub. Te muestro qué es, cómo funciona en 4 pasos y cómo ejecutarla con Docker.
Dify: Apps con LLMs Sin el Boilerplate
Dify supera las 154k estrellas como constructor open-source de apps con LLMs. Qué es, cómo funciona su arquitectura y los comandos Docker verificados para correrlo en local.
Stagehand: El SDK de IA Que Controla Tu Navegador
El SDK MIT de Browserbase con 24k estrellas combina código estilo Playwright con act, observe y extract para agentes de navegador fiables: arquitectura y quickstart verificado en 5 minutos.
Browser-Use: El Repo Open-Source que Enseña a los Agentes a Clickear
Cómo Browser-Use convierte un LLM en operador del navegador: 112k estrellas, licencia MIT, loop de 4 pasos, quickstart verificado y cuándo no usarlo.
Mem0: La Capa de Memoria que le Falta a tus Agentes de IA
Mem0 les da a tus agentes de IA memoria persistente de largo plazo con dos llamadas a la API — arquitectura, quickstart verificado y límites honestos.
Docker GPU en 2026: Desplegá Apps de IA con Compose
¿Tu modelo corre en tu GPU pero muere en un contenedor? La guía 2026 completa: NVIDIA Container Toolkit, reservas GPU en Compose, imágenes CUDA y builds multi-stage.
Rotación de Refresh Tokens JWT en Node.js
Access tokens de vida corta, refresh tokens rotativos con detección de reuso y cookies httpOnly: guía verificada de autenticación JWT lista para producción.
Chatbot IA con Next.js 2026: El Tutorial de Streaming
Creá un chatbot IA con streaming con Next.js y Vercel AI SDK: route handler, useChat y checklist de producción.
LangGraph en 2026: Un Agente de Soporte Que Sabe Cuándo Preguntar
Construí un agente de soporte con LangGraph: estado tipado, herramientas, memoria con checkpointer, aprobación humana con interrupt y tracing en LangSmith — verificado contra la docs actual.
Bases de Datos Vectoriales en 2026: pgvector vs Qdrant
¿Cuándo alcanza Postgres con pgvector para RAG y cuándo necesitas Qdrant? Fundamentos de HNSW, reglas de decisión y código verificado.
Structured Outputs en 2026: Dejá de Parsear Esperanzas, Parseá Schemas
Obtené JSON válido garantizado de los LLMs: strict mode de OpenAI, generateObject con Zod, tools estrictas de Anthropic y validación con Pydantic — con código real y verificado.
Prompt Caching en 2026: Guía de Costo y Latencia
Dejá de pagar el mismo system prompt en cada llamada: cómo funciona el caché de Anthropic, OpenAI y Gemini, con límites verificados y código listo.
Estrategias de Chunking para RAG que Sobreviven a Producción (2026)
Chunking fijo vs semántico vs tardío con números reales 2026, más una receta Python de tamaño, overlap y contextual retrieval.
GLM-5.3 en 2026: benchmarks, precios y guía de setup
GLM-5.3 es el flagship open-weights de Zhipu en 2026: 28.3 en Terminal-Bench 3.0, 66.9 en DeepSWE y 84.5% en CyberGym. Precios de API y setup en Claude Code.
Mistral Medium 3.5: el modelo abierto para agentes empresariales
128B open weights, 256K de contexto, 77.6% SWE-Bench Verified a $1.5/$7.5 — ficha, quickstart y límites honestos.
Gemma 3 para Edge AI: Ficha, Benchmarks y Quickstart
Gemma 3 y 3n de Google llevan la IA multimodal a teléfonos y edge — ficha real, benchmarks honestos y quickstart de 5 minutos con Ollama.
DeepSeek V4 en 2026: Benchmarks, Precios y Guía de API
DeepSeek V4 Pro y Flash a prueba: 80.6% en SWE-bench Verified, contexto de 1M y pesos MIT — benchmarks reales, precios oficiales y quickstart en 5 minutos.
Qwen3.8-Flash: ficha, benchmarks y guía local
Qwen3.8-Flash es el MoE de 125B de Alibaba con 6B activos y 262K de contexto. Ficha verificada, benchmarks vs el 27B, precios y setup local con Ollama y vLLM.
Claude Fable 5.1: el Lanzamiento 2026 Sobre el que Hay que Shippear
Claude Fable 5.1 (sep 2026): contexto 1M, $10/$50 por MTok, cache $0.25, adaptive thinking. Specs, benchmarks de laboratorio, código API y guía Opus 5.
La Ley GENIUS y las Stablecoins: Lo Que Todo Builder Fintech Debe Saber en 2026
Firmada en julio de 2025, en regulación durante 2026, vigente desde enero de 2027: reservas 1:1, solo emisores con licencia, sin yield. Qué cambiar ya.
Google AI Overviews 2026: El Manual GEO
AI Overviews llega a 2.5B de usuarios y recorta clics hasta 58% — datos 2026 verificados más el sprint GEO de 5 pasos.
GitHub Copilot Agent Mode: El Workflow de 2026
El agent mode convierte a Copilot en un programador autónomo: qué hace, cuánto cuesta en 2026 y el workflow que uso para entregar más rápido.
IA integrada en Chrome en 2026: la guía Gemini Nano
La Prompt API es estable, Summarizer y Translator llegan en Chrome 138+ y Writer/Rewriter siguen en trial — qué corre en el dispositivo y qué construir esta semana.
Chips NVIDIA Rubin: lo que todo dev de IA debe saber en 2026
Rubin ya está en producción total y los sistemas llegan en H2 2026: specs confirmadas, impacto de NVFP4/HBM4 en inferencia y checklist para devs.
GPT-OSS: El Modelo Abierto de OpenAI y Cómo Desplegarlo
Los gpt-oss 120b y 20b de OpenAI son open-weight bajo Apache 2.0 — specs verificadas y cómo correr el modelo 20b en local con Ollama o servirlo con vLLM.
Ley de IA de la UE 2026: Qué Cambia para Devs
Transparencia, reglas GPAI y multas vigentes desde agosto de 2026 — qué deben hacer esta semana los equipos con funciones de IA.
Por Qué Tu Agente de IA Pasa la Demo y Falla en Producción
Solo el 27% de los equipos corre evals antes de cada deploy. Aprende a evaluar agentes de IA en producción con DeepEval, LangSmith, datasets dorados, jueces calibrados y gates en CI que bloquean merges malos.
OpenRAG: La Plataforma RAG 100% Open Source de Langflow en un Solo Comando
Langflow lanzo OpenRAG, una plataforma RAG completa y open source construida sobre Langflow, Docling y OpenSearch. Un solo comando para ingestión de documentos, busqueda semantica y chat con tus datos, sin integraciones improvisadas.
Como Estar al Dia con las Noticias de IA: Fuentes, Herramientas y Rutinas
La IA avanza mas rapido que cualquier otra tecnologia. Descubri que newsletters leer, a quien seguir en X, que podcasts escuchar y como armar una rutina de 30 minutos diarios que te mantenga informado sin sobrecarga de informacion.
Gemini Embedding 2: El Nuevo Sistema de Embeddings Multimodal de Google
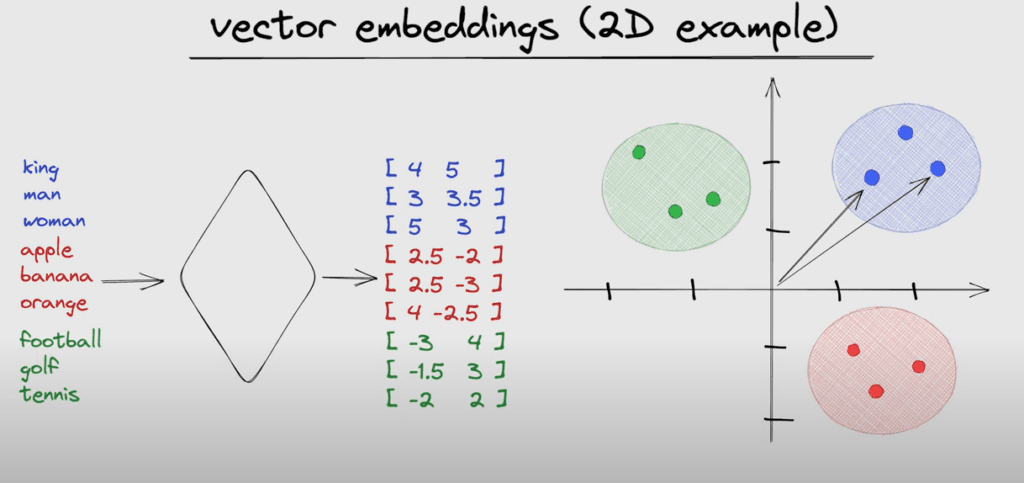
Que es un embedding y por que importa? Descubre Gemini Embedding 2, el modelo mas reciente de Google que unifica texto, imagenes, audio, video y PDFs en un unico espacio vectorial, y que significa para busqueda semantica y pipelines RAG.
MCP Explicado: El Protocolo Que Conecta Tus Agentes de IA al Mundo Real
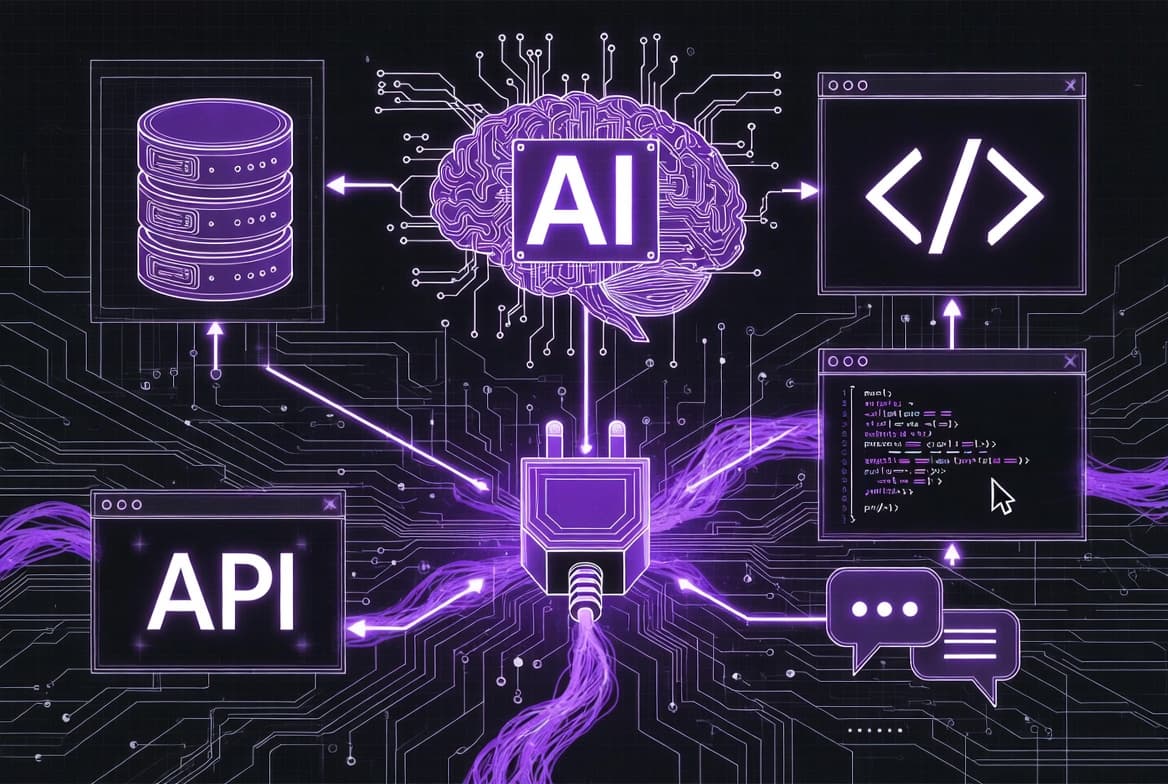
Model Context Protocol (MCP) de Anthropic es el estandar USB para la IA. Aprende como MCP conecta agentes de IA a herramientas, bases de datos, APIs y entornos de desarrollo con una guia practica.
Vibe Coding: Por Que el 90% de los Proyectos Construidos con IA Nunca Llegan a Produccion
Vibe coding fue nombrada la palabra del ano 2025. Es increible para prototipar pero devastador para produccion. Descubri por que el 90% de los proyectos vibe-coded fallan y como cerrar la brecha del prototipo IA a la aplicacion lista para produccion.
No, la IA No Reemplazara a los Desarrolladores. Pero los Desarrolladores que Usan IA Reemplazaran a los que No
El 84% de los desarrolladores ya usan IA a diario. La verdadera pregunta no es si la IA reemplazara a los programadores, sino si te adaptaras. Descubri que hace bien la IA, que no puede hacer y como preparar tu carrera para el futuro.
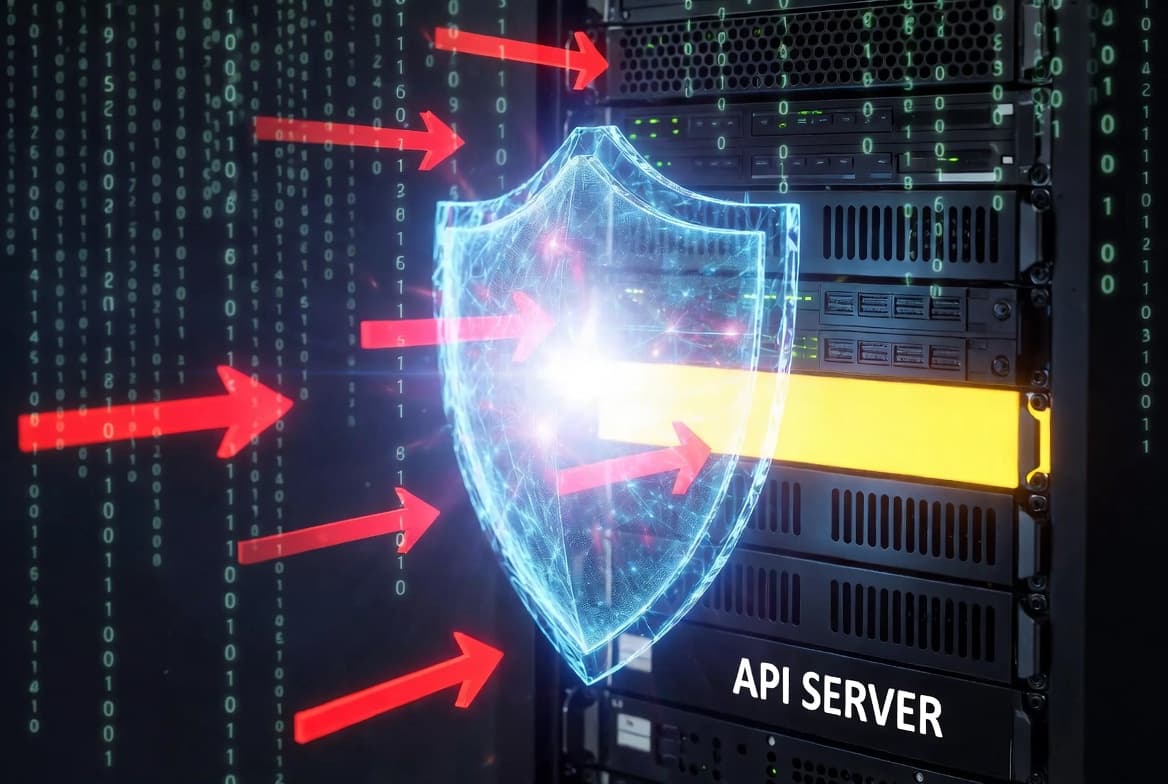
Tu API Esta Expuesta: 5 Vulnerabilidades Que la IA Encuentra en Segundos y los Desarrolladores Ignoran
La mayoria de las APIs llegan a produccion con vulnerabilidades criticas. Conoce las 5 fallas de seguridad mas comunes: autenticacion rota, exposicion excesiva de datos, falta de rate limiting, ataques de inyeccion y control de acceso roto, y como las herramientas de seguridad con IA las detectan en segundos.
GEO: Por Que la Optimizacion para Motores Generativos Es el Futuro de la Visibilidad Online
El SEO tradicional ya no es suficiente. Descubre como la Optimizacion para Motores Generativos (GEO) ayuda a tu negocio a ser citado por buscadores IA como ChatGPT, Perplexity y Google AI Overviews.
Cuando la IA Falla al Programar: De Prototipo a Pesadilla en Produccion
Por que el 80% de los proyectos generados con IA nunca llegan a produccion y como los desarrolladores profesionales pueden rescatar tus proyectos atascados. Conoce los errores comunes y obtene ayuda experta.
Como Construir Bots de Trading Rentables en 2025: Guia Completa
Aprende a desarrollar sistemas de trading algoritmico usando Python, framework Jesse y algoritmos de machine learning como PPO y SAC para ganancias consistentes.
Desarrollo de APIs Fintech: Seguridad y Escalabilidad
Construyendo APIs financieras seguras y escalables con Node.js, implementando autenticacion adecuada, limitacion de tasa y estandares de cumplimiento.
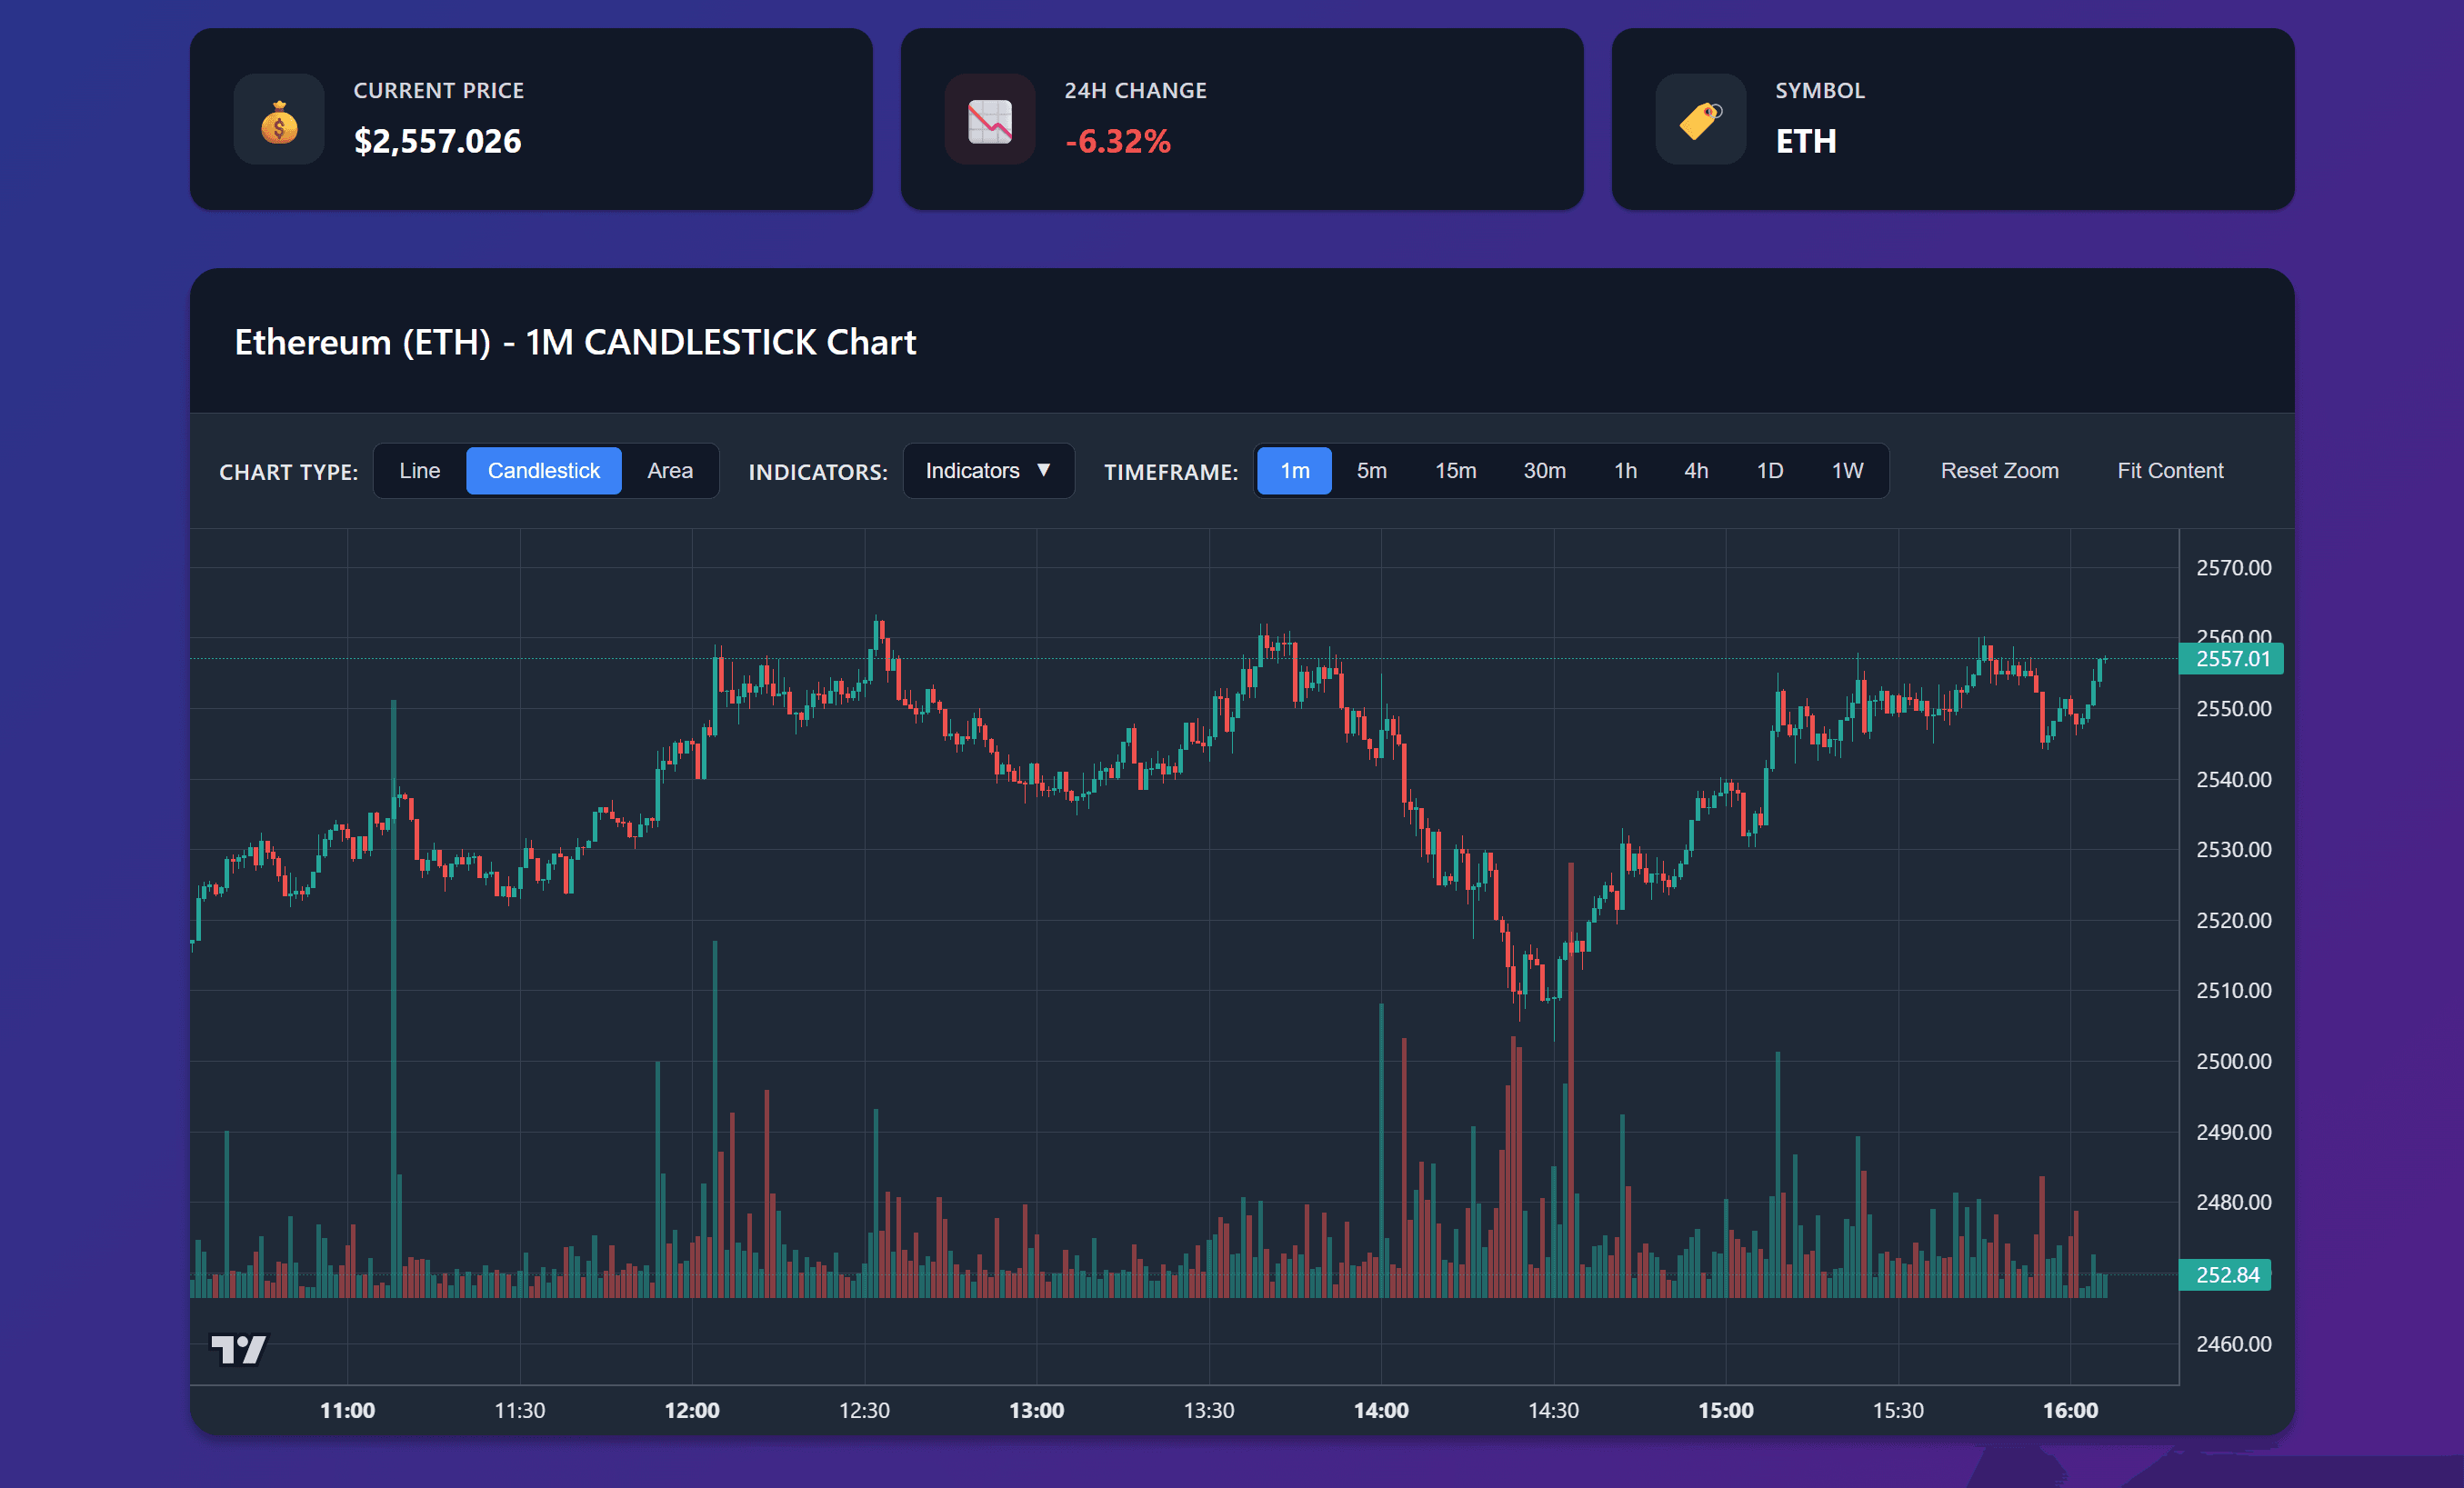
Construyendo Graficos Profesionales de Criptomonedas: Integracion TradingView y API de Binance
Guia completa para construir aplicaciones profesionales de graficos de criptomonedas con TradingView Lightweight Charts, integracion de API de Binance y streaming de datos en tiempo real.
Construyendo un DEX Pool Scanner: Analizando CLMM Pools en Solana con Rust
Aprende a construir una herramienta sofisticada de analiticas DeFi usando Rust para escanear y analizar pools de Concentrated Liquidity Market Maker en multiples DEXs de Solana como Raydium, Orca y Meteor.
Mejores Practicas de Desarrollo Web3 para Aplicaciones Empresariales
Descubre los patrones esenciales y consideraciones de seguridad al construir aplicaciones Web3 de nivel empresarial con React e integracion blockchain.
Desarrollo de Extensiones Chrome: De la Idea a Chrome Store
Guia paso a paso para construir, probar y publicar extensiones de Chrome que resuelven problemas reales y generan ingresos.